使用VIVADO xfft IP核进行基于流水线架构(Pipelined Streaming I/O )的快速傅里叶变换
## 简介快速傅里叶变换(Fast Fourier Transform, FFT)是一种计算效率高的算法,用于计算样本大小为2的正整数幂的离散傅里叶变换(DFT)。序列$x(n),n=0,\dots,N-1$的离散傅里叶变换DFT$X(k), k=1,\dots,N-1$的定义为:
$X(k)=\sum_{n=0}^{N-1}x(n)e^{-jnk2\pi/N}$
其中N是变换大小 $j=\sqrt{-1}$。逆DFT(IDFT)由下式给出:
$x(n)=\frac{1}{N}\sum_{k=0}^{N-1}X(k)e^{jnk2\pi/N}$
FFT核心使用Radix-4和Radix-2分解(基4或者基2分解)来计算DFT。对于Burst I/O架构,使用时间抽取(decimation-in-time, DIT)方法,而流水线I/O(the Pipelined Streaming)架构使用频率抽取(decimation-in-frequency,DIF)方法。当使用Radix-4分解时,N点FFT由log4(N)个阶段组成,每个阶段包含N/4个Radix-4蝶形运算。不是4的幂的点大小需要额外的Radix-2级来组合数据。使用Radix-2分解的N点FFT有log2(N)个阶段,每个阶段包含N/2个Radix-2蝶形。
通过共轭相应正向FFT的相位因子来计算逆FFT(IFFT)。FFT核心不实现逆FFT的1/N缩放。因此,缩放是按照正向FFT进行的,只是使用共轭相位因子(旋转因子)。
## 接口及端口说明
!(https://i-blog.csdnimg.cn/direct/45e43149c60044fb8cc3ed92af73654a.png)
总的来说,配置接口分为时钟、复位接口、IP核配置接口(s_axis_config)、IP核数据输入接口(s_axis_data)、IP数据输出接口(m_axis_data)、IP核状态接口(m_axis_status)和event接口,作为从机(slave)时,IP核作为数据输入,作为主机(master)时,IP核作为数据输出,下表[^1]是官方数据手册上介绍的各个接口的功能及相关描述。
| 接口名称 | 接口属性| 选择性 | 描述 |
|--|--|--|--|
|aclk |I| N |上升沿时钟|
|aclken |I |Y |高电平有效时钟使能信号|
|aresetn |I |Y |低电平有效同步复位(清零)优先级高于aclken最少需要两个时钟周期来进行复位|
|s_axis_config_tvalid| I |N |配置通道的TVALID(有效)信号 由外部主控提供信号,表明其可以提供数据|
|s_axis_config_tready| O |N |配置通道的TREADY(准备完成)信号 由IP核内部提供,表明其可以接受该数据|
|s_axis_config_tdata |I |N |配置通道的TDATA信号 |
|s_axis_data_tvalid| I |N |数据输入通道的TVALID信号 由外部主控提供信号,表明其可以提供数据|
|s_axis_data_tready |O| N |数据输入通道的TREADY信号,由内部IP提供,表面其可以接受该数据|
|s_axis_data_tdata| I | N| 数据输入通道的TDATA信号, 携带着未经处理的信号:XN_RE和XN_IM|
|s_axis_data_tlast |I | N | 输入数据通道的TLAST信号,由外部主控在帧的最后一个样本上提供。核心不使用它,除非生成事件event_tlast_unexpected和event_tlast_missing事件|
|m_axis_data_tvalid |O | N |输出数据通道的TVALID信号,由IP核内部提供,表示其可以输出信号|
|m_axis_data_tready| I |N |输出数据通道的TREADY 信号,由外部从机提供,表明其已经准备好开始接收信号,其仅在非实时模式下存在。|
|m_axis_data_tdata |O |N |数据输出通道的TDATA信号,携带了处理之后的信号XK_RE和XK_IM|
|m_axis_data_tuser |O |N |输出数据通道的TUSER信号,携带了可选择的每个数据信息,例如:XK_INDEX, OVFLO 和 BLK_EXP|
|m_axis_data_tlast |O |N |输出数据通道的TLAST信号,由内部核心提供的每一帧的最后一个数据|
|m_axis_status_tvalid |O |N |状态通道的TVALID信号,IP核内部提供,表明其可以提供状态数据|
|m_axis_status_tready |I |N |状态通道的TREADY信号,外部从机提供的信号,表面其准备好接收数据,仅在非实时模式下可用|
|m_axis_status_tdata |O |N |状态通道的TDATA信号,携带状态信号:BLK_EXP和OVFLO|
|event_frame_started |O |N |声明(Asserted)IP开始处理新的一帧信号
单个脉冲信号|
|event_tlast_unexpected |O |N |当核心在不是帧中最后一个的数据样本上看到s_axis_data_tlast High时声明。|
|event_tlast_missing |O |N |当s_axis_data_tlast在每一帧数据的最后一个为低|
|event_fft_overflow |O |Y |当从数据输出通道卸载的数据样本中出现溢出时,断言。仅当溢出是一个有效选项时才存在。|
|event_data_in_channel_halt |O |N |当核心从数据输入通道请求数据并且没有可用数据时,则断言。|
|event_data_out_channel_halt |O |N |当核心试图将数据写入数据输出通道但无法这样做时,会断言。仅在非实时模式下存在。|
|event_status_channel_halt |O |N |当核心试图将数据写入状态通道但无法这样做时,会断言。仅在非实时模式下存在。|
### s_axis_config_tdata配置数据
s_axis_config_tdata 携带的配置信息包含:
配置字段按以下顺序(从LSB开始)打包到s_axis_config_tdata向量中:
1、(optional)NFFT plus padding
2、(optional)CP_LEN plus padding
3、FDW_INV
4、(optional)SCALE_SCH
!(https://i-blog.csdnimg.cn/direct/1444297963ac4c12a2de690fefda55bc.png)
- NFFT:FFT点数,小于等于设置的最大点数,eg,1024位为2^10^,NFFT 最大为10。
- CP_LEN:循环前缀长度(log2最大点数尺寸)
- FWD_INV:变换形式,1:正变换,0:逆变换(宽度和通道数有关,由低到高分别为通道由低到高,最大宽度为8)
- SCALE_SCH:缩放规模表(2×ceil( $\frac{NFFT}{2}$)),对于突发I/O架构,缩放时间表为每个阶段指定两个比特,第一阶段的缩放由两个LSB给出。缩放可以指定为3、2、1或0,表示要移位的位数。
例如:N=1024,Radix-4突发I/O的示例缩放时间表为(从最后一级到第一级排序(倒序),基-4架构由五级运算组成,因此缩放表有五级参数)。对于N=128、Radix-2突发I/O或Radix-2精简突发I/O,一种可能的缩放规模是(从最后一级到第一级排序)。
对于流水线IO架构,缩放规模表从两个LSB开始为每对Radix-2级指定两个比特。例如,N=256的缩放规模可以是。当N不是4的幂时,最后一级的最大比特增长为1比特。例如,或是N=512的有效缩放计划,但无效。
需要注意的是:**如果所有带填充的字段尚未在8位边界上结束,则应将其扩展到下一个8位边界**。核心忽略填充位的值,因此可以将其驱动为任何值。将它们连接到常数值可能有助于减少设备资源的使用。
可选字段显示为虚线。请注意,s_axis_config_tdata的总线宽度可能超过容纳所有字段(包括SCALE_SCH)所需的宽度,即使SCALE_SCH字段被填充以确保宽度是8位的倍数。额外的比特未被使用,因此它们将在合成过程中被优化掉。
### s_axis_data_tdata输入数据
数据输入通道(s_axis_data)是一个AXI通道,在其TDATA矢量中携带下表中的字段,其中XN_RE和XN_IM就表示文章开头介绍的待进行FFT变换的时域数据,而下面的XK_RE和XK_IM表示FFT变换后的频域数据。
|名称|位宽|是否需要位填充|描述|
|-|-|-|-|
|XN_RE|$b_{xn}$|Y|输入数据的实部($b_{xn}$ = 8-34),采用**二进制补码(有符号整数,该点需要注意)**或者单精度浮点数格式|
|XN_IM|$b_{xn}$|Y|输入数据的虚部($b_{xn}$ = 8-34),同样采用**二进制补码(有符号整数,该点需要注意)**或者单精度浮点数格式|
需要注意的是,**如果所有带填充的字段尚未在8位边界上结束,则应将其扩展到下一个8位边界**。IP核会忽略填充位的值,因此可以将其驱动为任何值。将它们连接到常量值可以帮助减少设备资源的使用。然后对设计中的每个通道重复这些字段。
!(https://i-blog.csdnimg.cn/direct/c64b9691cb9247acb8d518b66e438a21.png)
### m_axis_data_tdata输出数据
数据输出通道包含FFT变换后的实部XK_RE和虚部XK_IM。TUSER携带了与TDATA上样本数据相关的每个数据的状态信息。该状态信息旨在供直接处理数据样本的下游从属设备使用。由于数据在同一通道中传输,它不能与数据不同步。以下信息按样品TDATA的数据分类:
#### TDATA
数据输出通道(m_axis_data)是一个AXI通道,在其TDATA矢量中携带表3-9中的字段。
|名称|位宽|是否需要位填充|描述|
|-|-|-|-|
|XK_RE|$b_{xk}$|Y|输出数据的实部,采用**二进制补码(有符号整数,该点需要注意)**或者单精度浮点数格式,在配置时选用了缩放或者块浮点算法下,$b_{xk}=b_{xn}$;对于非缩放算法,$b_{xk}=b_{xn}+NFFT+1$,这里的NFFT为配置时,输入数据位宽;对于单精度浮点运算,$b_{xk}=32$|
|XK_IM|$b_{xk}$|Y|输出数据的虚部($b_{xk}$ = 8-34),同样采用**二进制补码(有符号整数,该点需要注意)**或者单精度浮点数格式,其位宽和XK_RE相同|
与s_axis_data_tdata数据格式类似,**如果所有带填充的字段尚未在8位边界上结束,则应将其扩展到下一个8位边界**,其数据格式如下表,对应的参数示例可查看数据手册:
!(https://i-blog.csdnimg.cn/direct/f08728934f7841fd9e31de27694f9962.png)
#### TUSER
TUSER携带了输出数据的状态信息
|名称|位宽|是否需要位填充|描述|
|-|-|-|-|
|XK_INDEX|NFFT|Y|输出数据索引,可选字段,格式为无符号二进制补码|
|BLK_EXP|8|Y|块指数,所应用的缩放系数,无符号二进制补码,可选字段,仅在块浮点运算时可用(block floating-point)|
|OVFLO|1|N|算术溢出指示器,高电平有效,如果数据帧中的任何值溢出,则OVFLO在结果卸载期间为高。OVFLO信号在新数据帧开始时重置。核心具有的每个FFT信道都包含一个单独的OVFLO字段。此端口是可选的,仅适用于缩放算术或单精度浮点I/O。|
!(https://i-blog.csdnimg.cn/direct/a01bfb85db7a4b4bb30c3f935ab40ae9.png)
#### 有限字长考虑的因素
每次通过运算时,该算法都会执行Radix-4或Radix-2蝶形,其中每个蝶形分别拾取四个或两个复数,并将四个或二个复数返回到同一内存中。核心返回到内存的数字可能大于从内存中提取的数字。
使用**全精度未缩放算术(full-precision unscaled arithmetic)**时,保留所有有效整数位。数据路径的宽度增加,以适应通过蝶形结构的比特增长。乘法产生的分数位的增长在乘法后被截断(或四舍五入)。**输出的宽度为(输入宽度+log2(变换长度)+1)**。这适应了比特增长的最坏情况。
使用**缩放(scaling)**时,在每个阶段使用缩放计划(scaling schedule)除以1、2、4或8。如果缩放不足,蝶形输出可能会超出动态范围并导致溢出。由于在FFT实现中应用了缩放,因此计算出的变换是缩放变换。比例因子s定义为:
$s=2^{\sum_{i=0}^{log(N-1)}b_i}$
其中$b_i$是每个阶段的缩放因子
缩放结果导致最终的输出序列以$1/s$倍调整,对于FFT,经过核心计算后的输出序列$X^{\prime}(k), k=0, \dots, N-1$为:
$X^{\prime}(k)=\frac{1}{s}X(k)=\frac{1}{s}\sum_{n=0}^{N-1}x(n)e^{-jnk2\pi/N}$
对于傅里叶逆变换IFFT而言,输出的序列为:
$x(n)=\frac{1}{s}\sum_{k=0}^{N-1}X(k)e^{jnk2\pi/N}$
#### 架构选择
FFT IP核提供了四个可用的架构,以便在转换时间和资源消耗两个方面进行权衡。其中流水型架构可用于连续数据处理,下图为四种架构的吞吐量和资源消耗的对比。
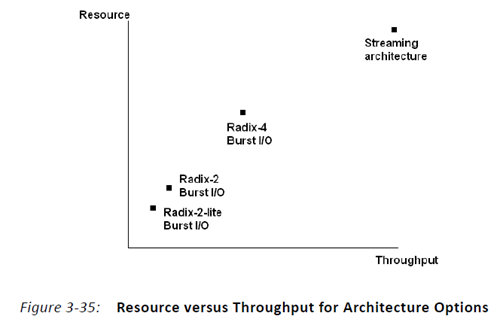
每种架构都提供输出数据的自然或反向排序选项,数据以自然顺序输入。FFT算法在处理过程中对样本进行重新排序,使得以自然顺序输入的数据以相反的顺序输出。核心可以选择按自然顺序输出数据。然而,这给每种架构都带来了成本。对于突发I/O架构,这会带来时间损失,因为卸载数据不能与加载下一帧的输入数据同时进行,因此需要单独的卸载和加载阶段。在流水线架构中,它需要额外的RAM存储来执行重新排序。
流水线流式I/O解决方案将多个Radix-2蝶形处理引擎流水线化,以提供连续的数据处理。每个处理引擎都有自己的存储体来存储输入和中间数据(图3-36)。核心能够同时对当前数据帧执行变换计算,加载下一帧数据的输入数据,并卸载前一帧数据结果。您可以连续输入数据,并在计算延迟后连续卸载结果。如果愿意,这种设计也可以单独计算一个帧或中间有间隙的帧。
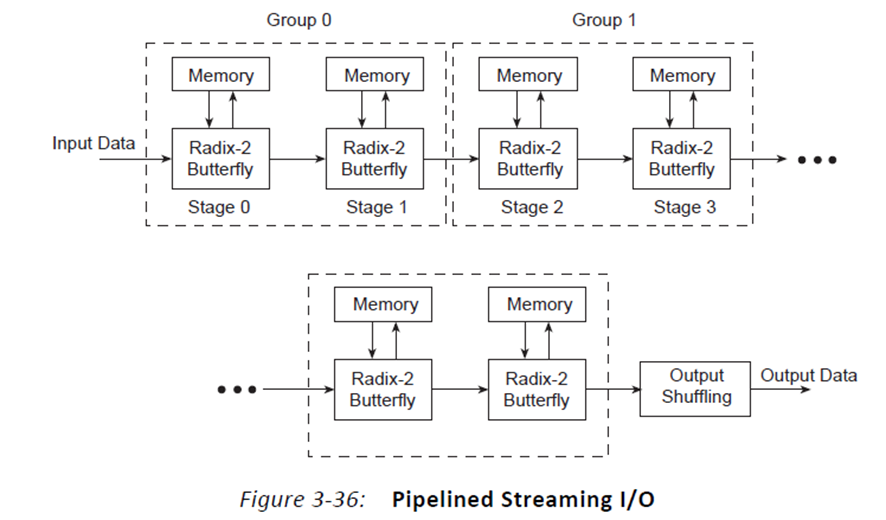
*连续流数据并不意味着可以忽略来自FFT核心的AXI4流等待状态。在某些情况下,FFT核心可能必须插入等待状态来暂停传入的采样数据。
在缩放定点模式(scaled fixed-point mode)下,数据在每对Radix-2级后缩放。块浮点模式(block floating-point mode)可能比缩放模式(the scaled mode)使用更多的资源,因为它必须保持额外的精度,以允许动态缩放而不影响性能。因此,如果输入数据被很好地理解并且不太可能表现出较大的幅度波动,则使用缩放算法(具有适当的缩放时间表以避免已知最坏情况下的溢出)就足够了,并且可以节省资源。
输入数据以自然顺序呈现。未加载的输出数据可以是位反转顺序或自然顺序。当选择自然顺序输出数据时,会利用额外的内存资源。
## 配置流程
- step1
!(https://i-blog.csdnimg.cn/direct/2458f54810c94f03b7b3cd50d45c0a6f.png)
-step2
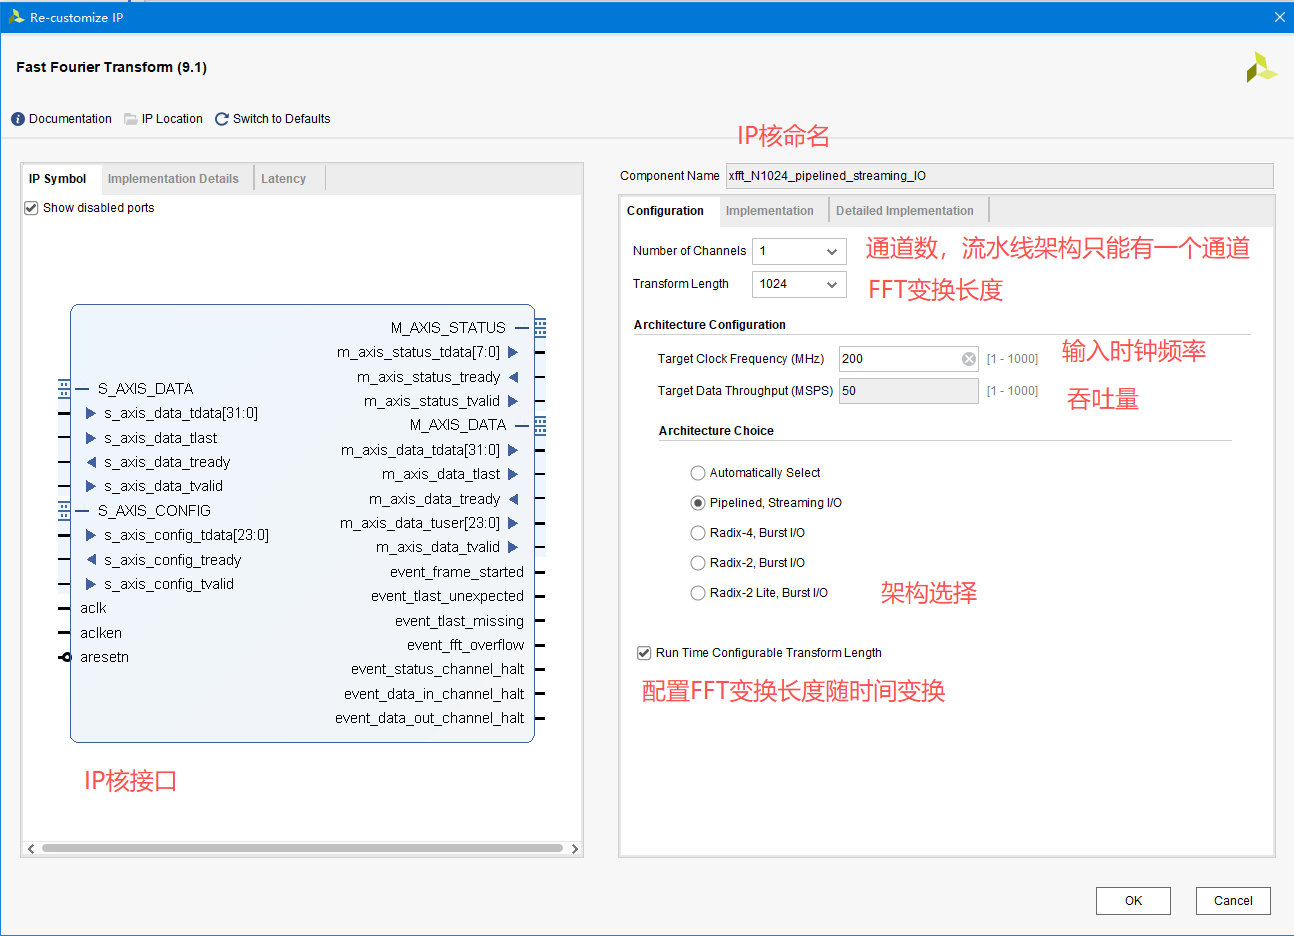
- step3
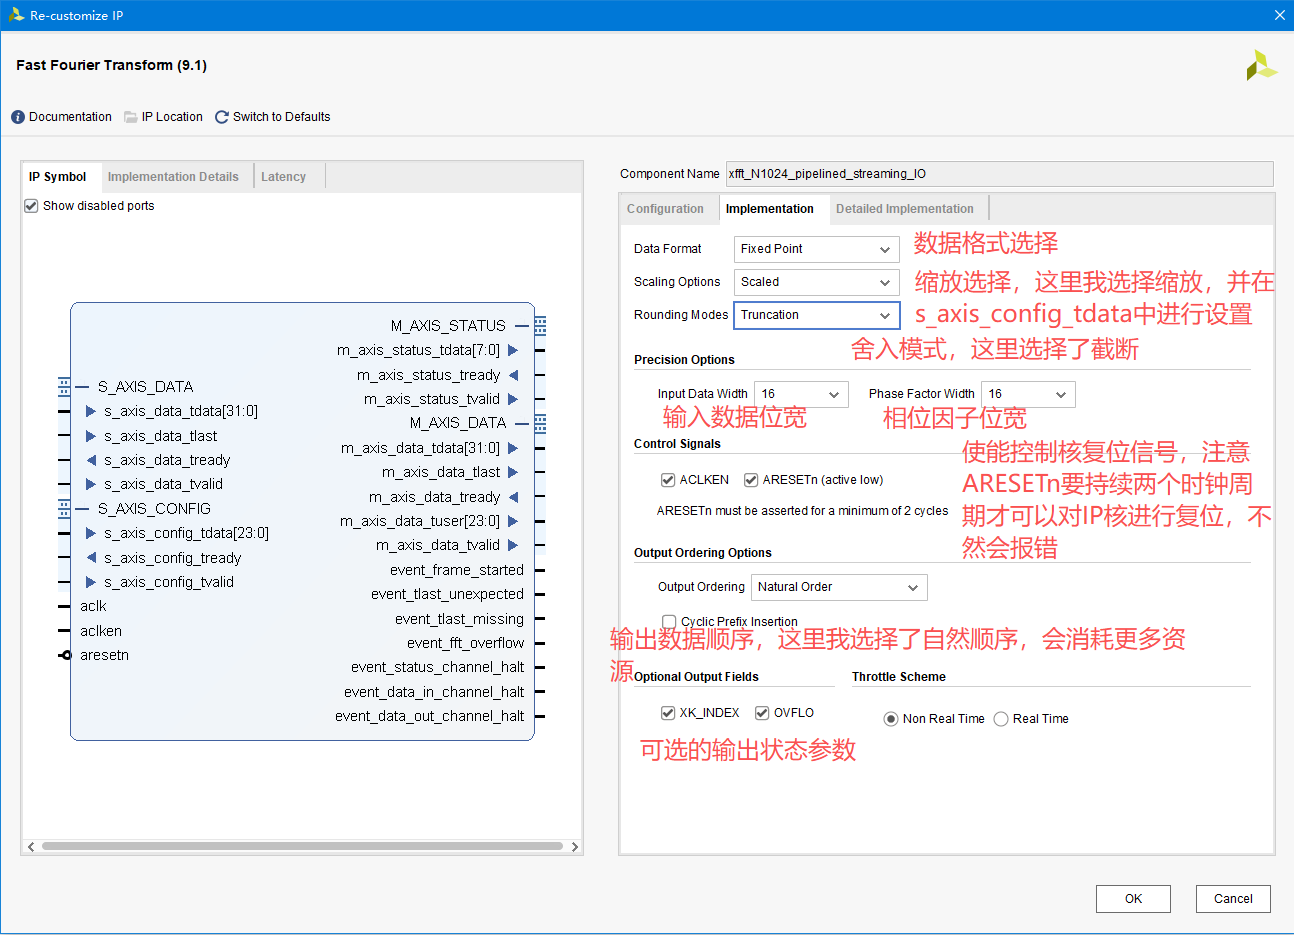
- step4
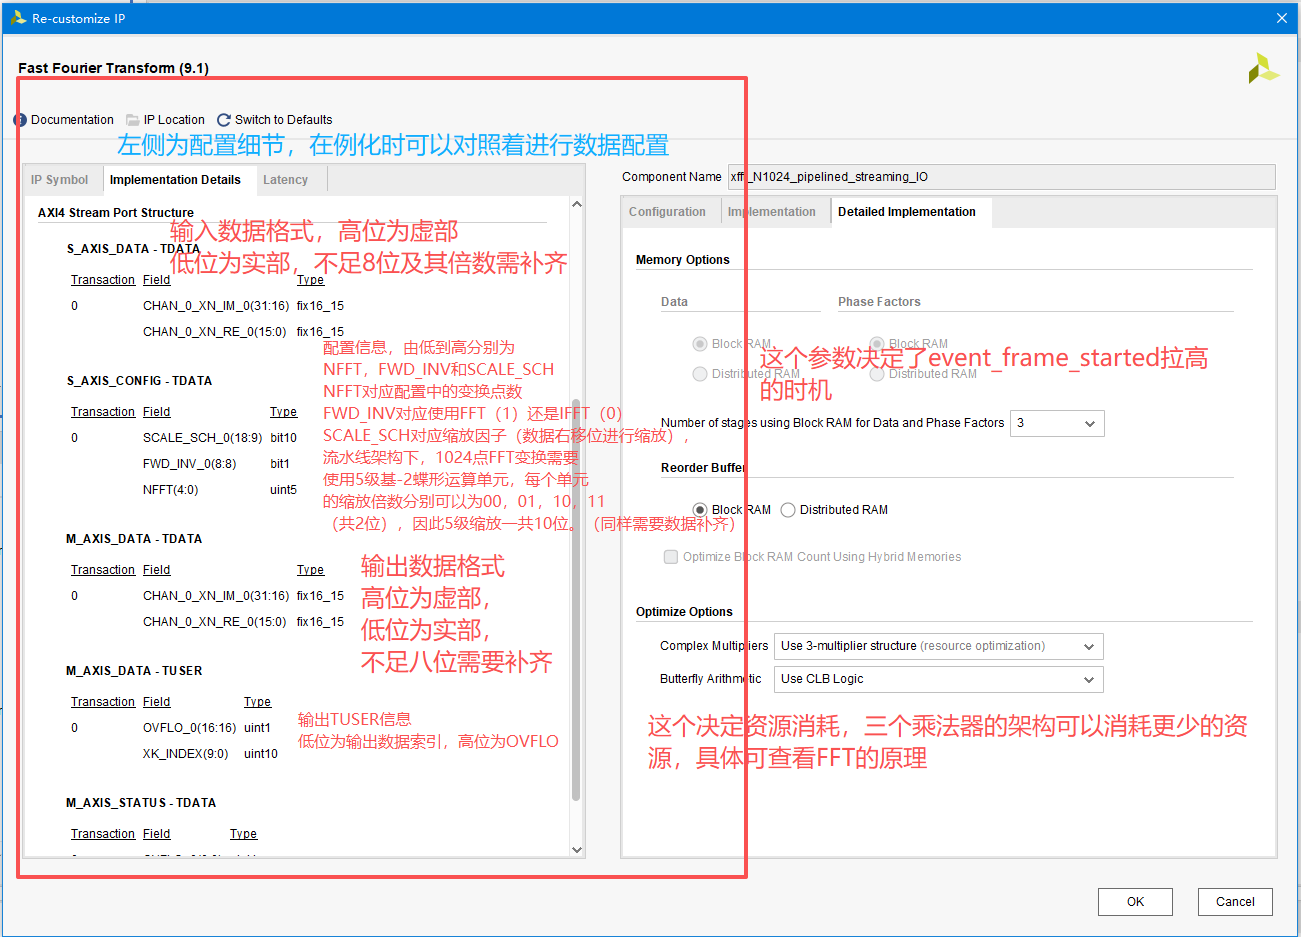
- step5
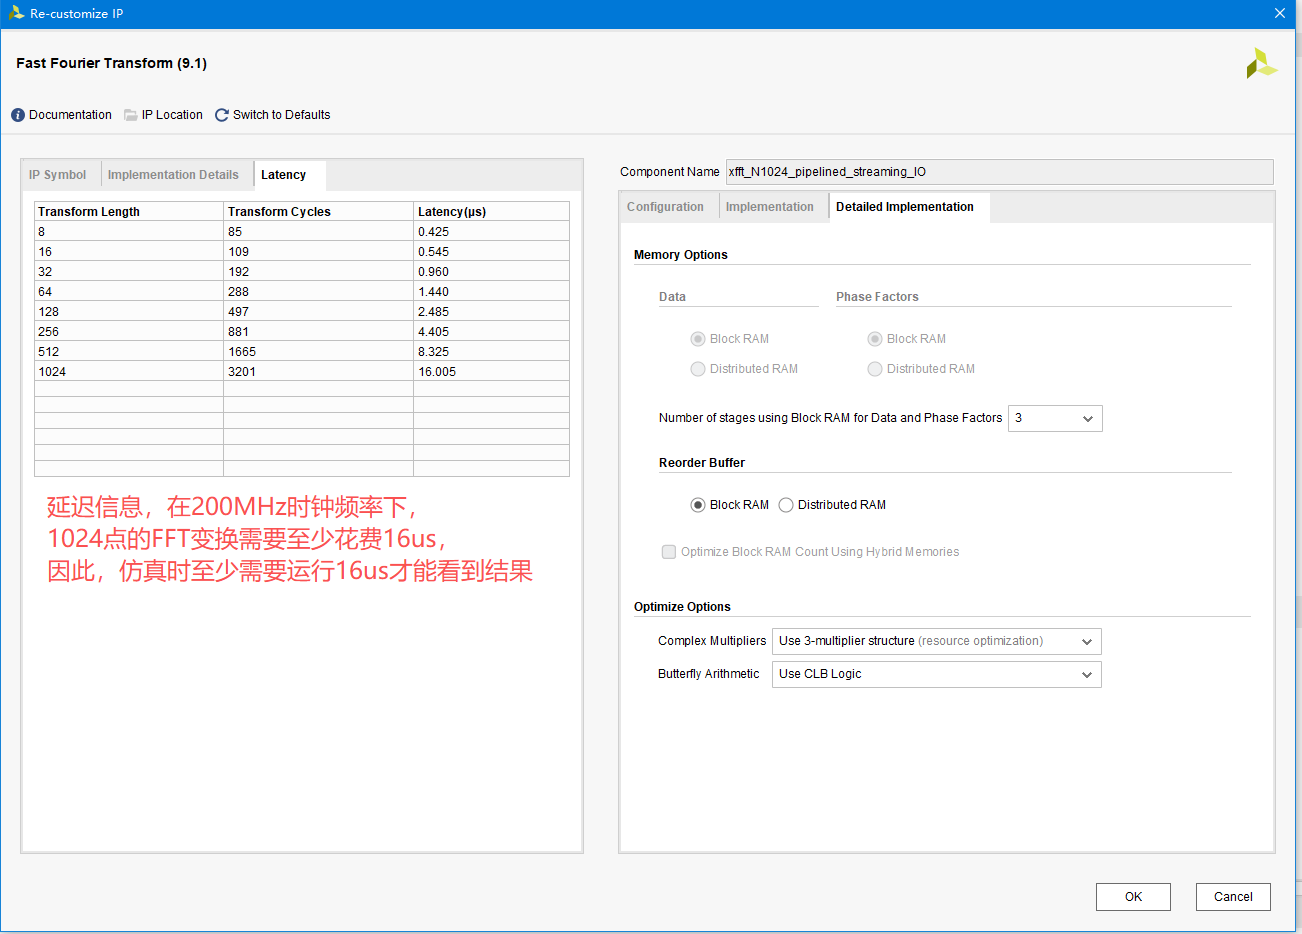
-
- step5
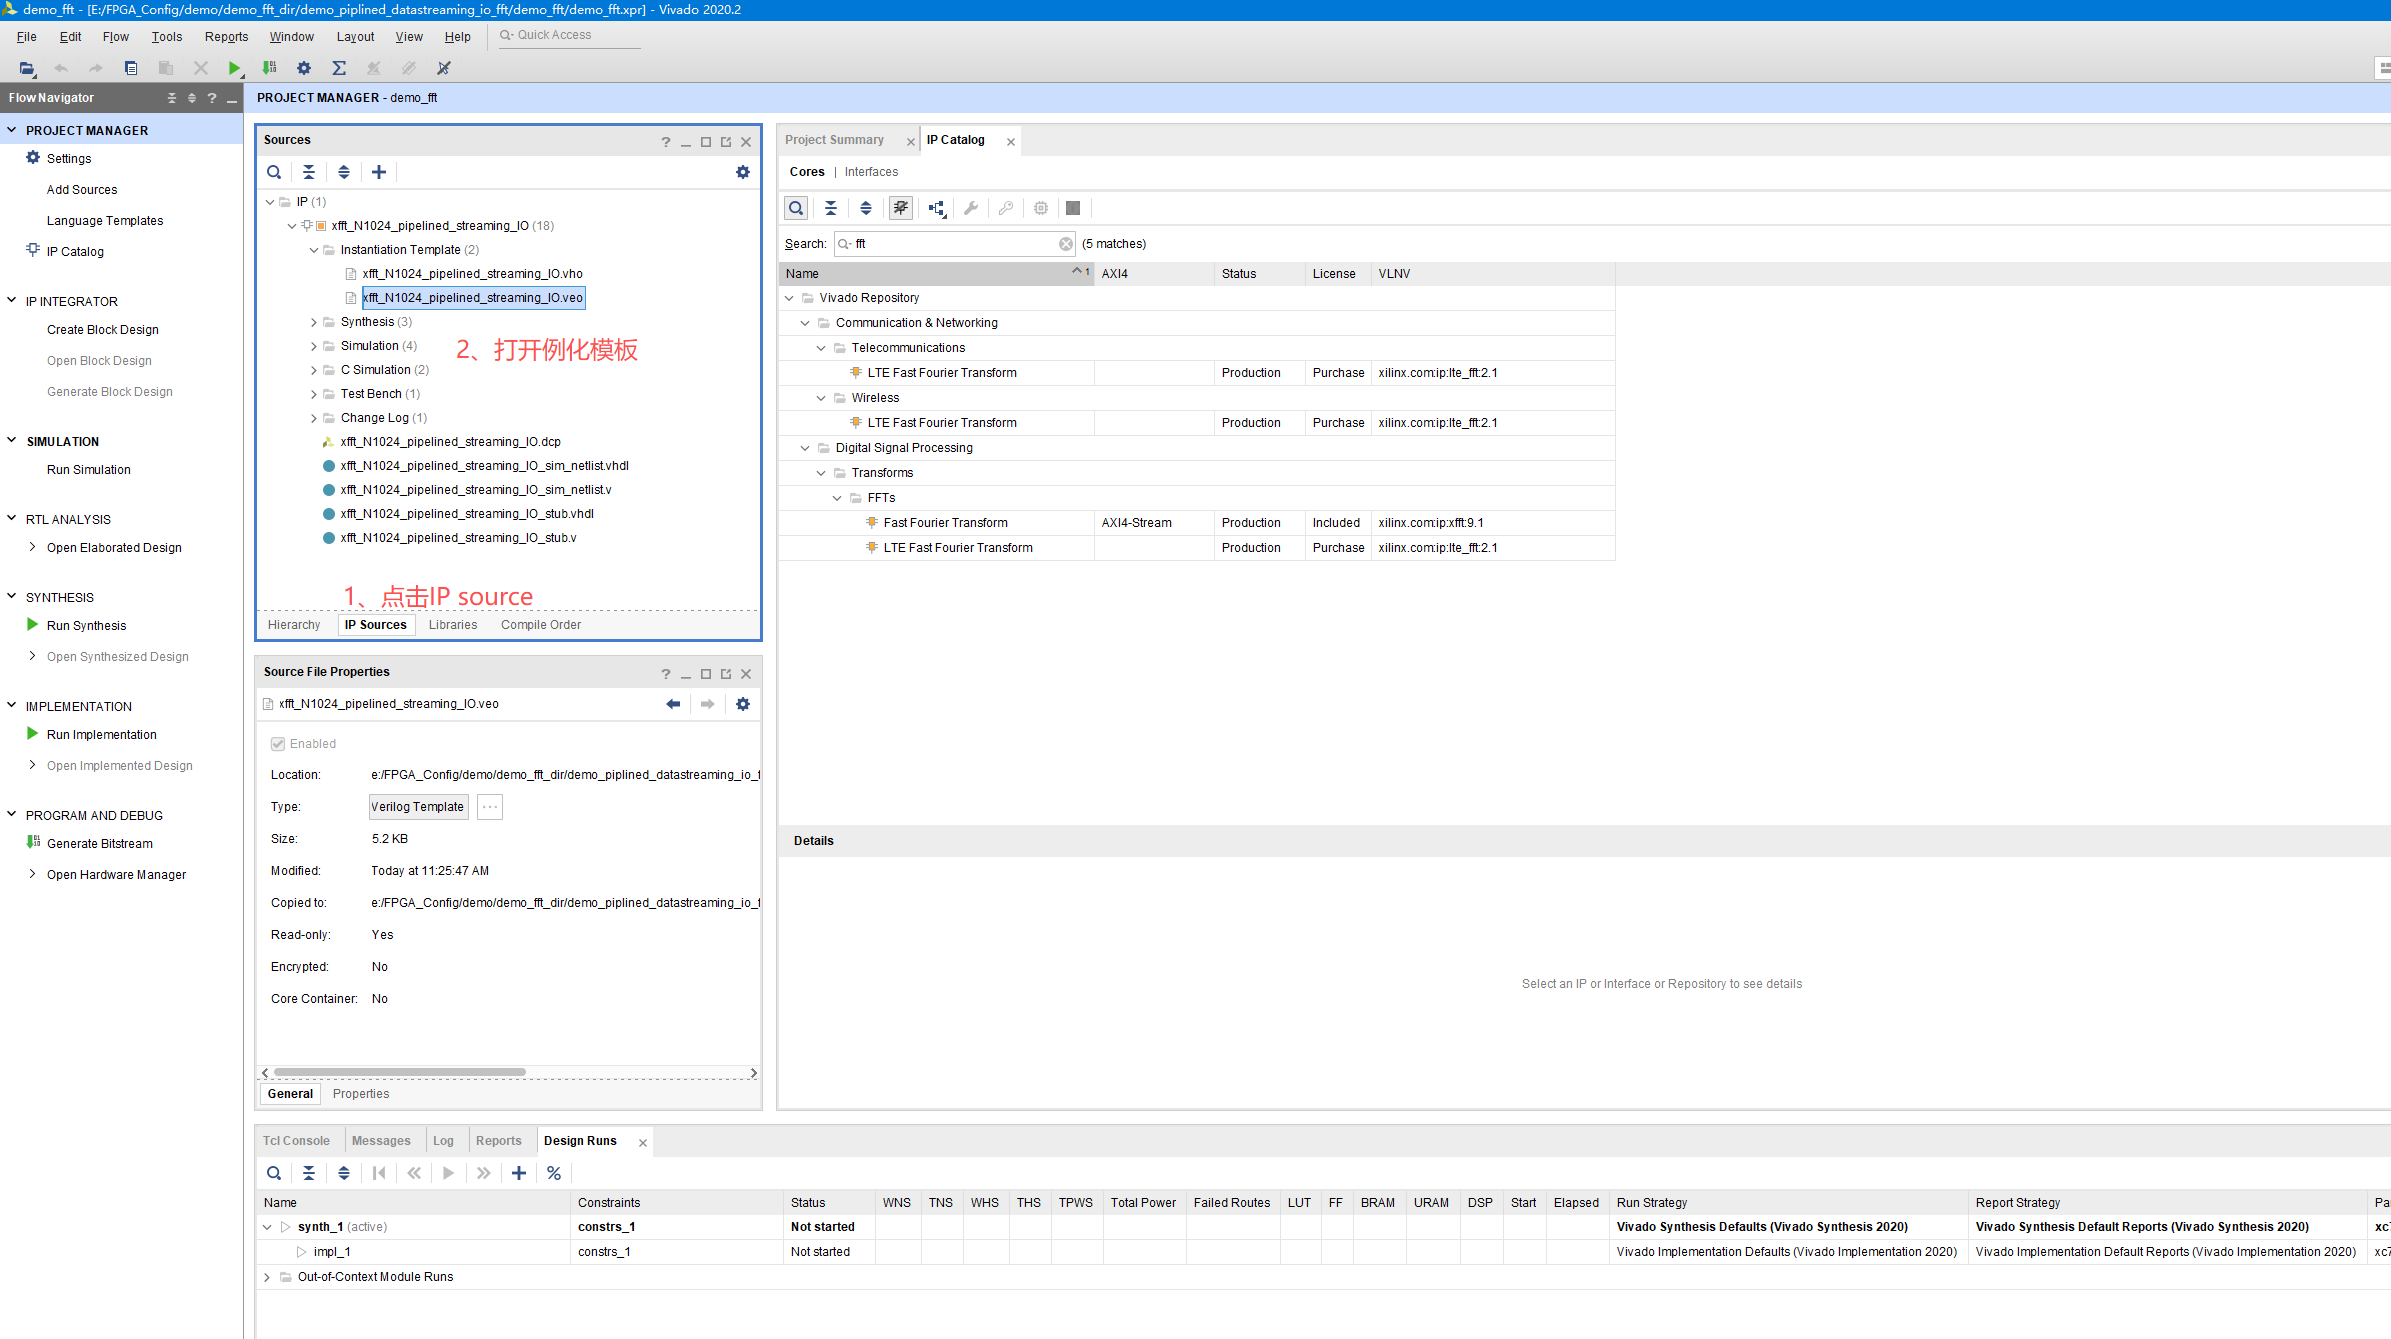
例化模板
```verilog
xfft_N1024_pipelined_streaming_IO your_instance_name (
.aclk(aclk), // input wire aclk
.aclken(aclken), // input wire aclken
.aresetn(aresetn), // input wire aresetn
.s_axis_config_tdata(s_axis_config_tdata), // input wire s_axis_config_tdata
.s_axis_config_tvalid(s_axis_config_tvalid), // input wire s_axis_config_tvalid
.s_axis_config_tready(s_axis_config_tready), // output wire s_axis_config_tready
.s_axis_data_tdata(s_axis_data_tdata), // input wire s_axis_data_tdata
.s_axis_data_tvalid(s_axis_data_tvalid), // input wire s_axis_data_tvalid
.s_axis_data_tready(s_axis_data_tready), // output wire s_axis_data_tready
.s_axis_data_tlast(s_axis_data_tlast), // input wire s_axis_data_tlast
.m_axis_data_tdata(m_axis_data_tdata), // output wire m_axis_data_tdata
.m_axis_data_tuser(m_axis_data_tuser), // output wire m_axis_data_tuser
.m_axis_data_tvalid(m_axis_data_tvalid), // output wire m_axis_data_tvalid
.m_axis_data_tready(m_axis_data_tready), // input wire m_axis_data_tready
.m_axis_data_tlast(m_axis_data_tlast), // output wire m_axis_data_tlast
.m_axis_status_tdata(m_axis_status_tdata), // output wire m_axis_status_tdata
.m_axis_status_tvalid(m_axis_status_tvalid), // output wire m_axis_status_tvalid
.m_axis_status_tready(m_axis_status_tready), // input wire m_axis_status_tready
.event_frame_started(event_frame_started), // output wire event_frame_started
.event_tlast_unexpected(event_tlast_unexpected), // output wire event_tlast_unexpected
.event_tlast_missing(event_tlast_missing), // output wire event_tlast_missing
.event_fft_overflow(event_fft_overflow), // output wire event_fft_overflow
.event_status_channel_halt(event_status_channel_halt), // output wire event_status_channel_halt
.event_data_in_channel_halt(event_data_in_channel_halt), // output wire event_data_in_channel_halt
.event_data_out_channel_halt(event_data_out_channel_halt)// output wire event_data_out_channel_halt
);
```
## 代码设置
### 控制(握手)规则
下图显示了AXI4流通道中的数据传输。TVALID由信道的源(master)侧驱动,TREADY由接收器(slave)驱动。TVALID表示有效载荷字段(TDATA、TUSER和TLAST)中的值有效。TREADY表示从属设备已准备好接收数据。当TVALID和TREADY在一个循环中都为真时,就会发生传输。主设备和从设备分别为下一次传输设置了TVALID和TREADY。
所有AXI通道都遵循相同的规则:
所有TDATA和TUSER字段都以低位编址(little endian)格式打包。也就是说,子字段的位0与TDATA或TUSER的位0对齐到同一侧。
字段不包含在TDATA或TUSER中,除非核心配置为需要字段存在。例如,如果核心被配置为具有定点大小,则没有比特被分配给指定点大小的NFFT字段。
所有TDATA和TUSER矢量都是8位的倍数。当TDATA或TUSER向量中的所有字段被连接时,整个向量会被填充,使其达到8位边界。
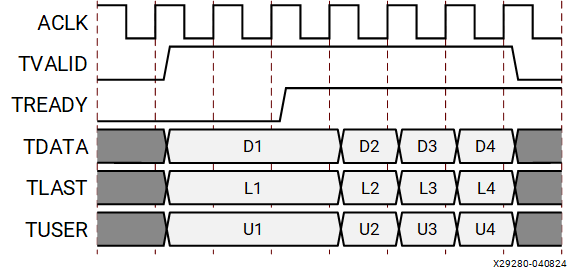
按照上述规则在主程序中进行例化,并配置相关控制信号 (这里没有对齐这一步,具体使用时应该使用FIFO进行数据缓冲和对齐)
```verilog
`timescale 1ns / 1ps
module demo_fft(
input sys_clk ,
input reset_n ,
input in_data ,
output XK_RE ,
output XK_IM
);
wire s_axis_config_tdata ;
reg s_axis_config_tvalid ;
wire s_axis_config_tready ;
wire s_axis_data_tdata ;
reg s_axis_data_tvalid ;
wire s_axis_data_tready ;
reg s_axis_data_tlast ;
wire m_axis_data_tdata ;
wire m_axis_data_tuser ;
wire m_axis_data_tvalid ;
reg m_axis_data_tready ;
wire m_axis_data_tlast ;
wire [ 7: 0] m_axis_status_tdata ;
wire m_axis_status_tvalid ;
reg m_axis_status_tready ;
wire event_frame_started ;
wire event_tlast_unexpected ;
wire event_tlast_missing ;
wire event_fft_overflow ;
wire event_status_channel_halt ;
wire event_data_in_channel_halt;
wire event_data_out_channel_halt;
reg [ 4: 0] NFFT =10;//变换点数
reg FWD_INV =1;//变换形式
reg [ 9: 0] SCALE_SCH ={2'd2,2'd2,2'd2,2'd2,2'd2}; //缩放因子
assign s_axis_config_tdata = {5'b0,SCALE_SCH,FWD_INV,3'b0,NFFT}; //s_axis_config_tdata 参数配置
assign s_axis_data_tdata = {16'd0,in_data};//s_axis_data_tdata 配置
//输出数据
assign XK_RE = m_axis_data_tdata;
assign XK_IM = m_axis_data_tdata;
wire [ 9: 0] XK_INDEX ;//输出数据索引
wire OVFLO ;
reg data_cnt ;
assign XK_INDEX = m_axis_data_tuser;
assign OVFLO = m_axis_data_tuser;
//IP核参数配置信号
always @(posedge sys_clk or negedge reset_n)begin
if(~reset_n)begin
s_axis_config_tvalid<= 'b0;
end else if(event_frame_started == 1)begin
s_axis_config_tvalid<=0;
end else begin
s_axis_config_tvalid<= 1;
end
end
//IP核数据传输信号
always @(posedge sys_clk or negedge reset_n)begin
if(~reset_n)begin
s_axis_data_tvalid<= 'b0;
data_cnt <= 12'd0;
end else if(s_axis_data_tready == 1)begin
if(data_cnt == 1022)begin//在即将传输最后一位时,拉高s_axis_data_tlast
data_cnt <= data_cnt +1 ;
s_axis_data_tlast <= 1 ;
end else if(data_cnt == 1023 )begin //最后一位,然后输入数据索引置零
data_cnt <= 0;
s_axis_data_tlast <= 0 ;
end else begin
s_axis_data_tlast <= 0 ;
data_cnt <= data_cnt + 1;
end
end else begin
s_axis_data_tvalid<= 1 ;
s_axis_data_tlast <= 0 ;
data_cnt <= data_cnt;
end
end
//配置接收数据信号
always @(posedge sys_clk or negedge reset_n)begin
if(~reset_n)begin
m_axis_data_tready <= 1'b0;
end else if(m_axis_data_tvalid ==1)begin
m_axis_data_tready <= 1'b1;
end else begin
m_axis_data_tready <= 1'b0;
end
end
//配置IP核状态信号
always @(posedge sys_clk or negedge reset_n)begin
if(~reset_n)begin
m_axis_status_tready <= 1'b0;
end else if(m_axis_status_tvalid ==1)begin
m_axis_status_tready <= 1'b1;
end else begin
m_axis_status_tready <= 1'b0;
end
end
xfft_N1024_pipelined_streaming_IO xfft_N1024_pipelined_streaming_IO_inst1 (
.aclk (sys_clk ), // input wire aclk
.aclken (1'b1 ), // input wire aclken
.aresetn (reset_n ), // input wire aresetn
.s_axis_config_tdata (s_axis_config_tdata ), // input wire s_axis_config_tdata
.s_axis_config_tvalid (s_axis_config_tvalid ), // input wire s_axis_config_tvalid
.s_axis_config_tready (s_axis_config_tready ), // output wire s_axis_config_tready
.s_axis_data_tdata (s_axis_data_tdata ), // input wire s_axis_data_tdata
.s_axis_data_tvalid (s_axis_data_tvalid ), // input wire s_axis_data_tvalid
.s_axis_data_tready (s_axis_data_tready ), // output wire s_axis_data_tready
.s_axis_data_tlast (s_axis_data_tlast ), // input wire s_axis_data_tlast
.m_axis_data_tdata (m_axis_data_tdata ), // output wire m_axis_data_tdata
.m_axis_data_tuser (m_axis_data_tuser ), // output wire m_axis_data_tuser
.m_axis_data_tvalid (m_axis_data_tvalid ), // output wire m_axis_data_tvalid
.m_axis_data_tready (m_axis_data_tready ), // input wire m_axis_data_tready
.m_axis_data_tlast (m_axis_data_tlast ), // output wire m_axis_data_tlast
.m_axis_status_tdata (m_axis_status_tdata ), // output wire m_axis_status_tdata
.m_axis_status_tvalid (m_axis_status_tvalid ), // output wire m_axis_status_tvalid
.m_axis_status_tready (m_axis_status_tready ), // input wire m_axis_status_tready
.event_frame_started (event_frame_started ), // output wire event_frame_started
.event_tlast_unexpected (event_tlast_unexpected ), // output wire event_tlast_unexpected
.event_tlast_missing (event_tlast_missing ), // output wire event_tlast_missing
.event_fft_overflow (event_fft_overflow ), // output wire event_fft_overflow
.event_status_channel_halt (event_status_channel_halt ), // output wire event_status_channel_halt
.event_data_in_channel_halt (event_data_in_channel_halt), // output wire event_data_in_channel_halt
.event_data_out_channel_halt (event_data_out_channel_halt) // output wire event_data_out_channel_halt
);
endmodule
```
## 仿真设置
- step1
使用matlab生成测试信号(chatGPT生成)
```verilog
%% MATLAB 脚本:生成 Vivado FFT 仿真输入信号(10帧 × 1024点)
clear; clc; close all;
%----------------------------------
% 参数设置
%----------------------------------
Fs = 200e6; % 采样率 200 MHz
N_fft = 1024; % 每帧点数
num_frames = 10; % 帧数
N_total = N_fft * num_frames; % 总样本数
t = (0:N_total-1)/Fs; % 时间轴
f1 = 1e6; % 1 MHz
f2 = 5e6; % 10 MHz
f3 = 10e6; % 15 MHz
f4 = 20e6; % 15 MHz
%----------------------------------
% 生成信号
%----------------------------------
x = 0.5*sin(2*pi*f1*t) + 0.5*sin(2*pi*f2*t) + 0.5*sin(2*pi*f3*t) + 0.5*sin(2*pi*f4*t);
%----------------------------------
% 量化为16位有符号整数
%----------------------------------
x_int16 = int16(x * (2^15 - 1)/max(x));
%----------------------------------
% 生成 Vivado 可读取的 HEX 文件
%----------------------------------
filename_hex = 'E:\FPGA_Config\demo\demo_fft_dir\demo_piplined_datastreaming_io_fft\fft_input_10frames_hex.txt';
fid = fopen(filename_hex, 'w');
for i = 1:length(x_int16)
val = typecast(x_int16(i), 'uint16'); % 转换补码表示
fprintf(fid, '%04X\n', val);
end
fclose(fid);
disp([' 已生成 Vivado 输入文件: ', filename_hex]);
%----------------------------------
% 绘图验证
%----------------------------------
% 显示第一帧波形
figure;
subplot(2,1,1);
n_show = N_fft; % 显示一帧
plot((0:n_show-1)/Fs*1e6, double(x_int16(1:n_show))/2^15);
xlabel('Time (µs)');
ylabel('Amplitude');
title('Time Domain (Frame 1)');
grid on;
% 显示频谱
subplot(2,1,2);
X = fft(x(1:N_fft));
f_axis = (0:N_fft-1)*(Fs/N_fft)/1e6;
plot(f_axis, (X)/max(abs(X)));
xlabel('Frequency (MHz)');
ylabel('Normalized Magnitude');
title('FFT Spectrum of Frame 1');
xlim();
grid on;
```
运行后得到仿真数据
!(https://i-blog.csdnimg.cn/direct/599c35ef49a64549bdf7876ae3c53b20.png)
- step2
编写测试代码
```verilog
`timescale 1ns / 1ps
module demo_fft_sim( );
reg sys_clk=0;
reg reset_n=0;
reg in_data;
wire XK_RE;
wire XK_IM;
//----------------------------------
// 数据存储
//----------------------------------
reg mem ; // 10帧×1024点 = 10240样本
integer i;
initial begin
#1.5
reset_n = 0;
#20
reset_n = 1;
// 从文件读取输入数据
$readmemh("E:/FPGA_Config/demo/demo_fft_dir/demo_piplined_datastreaming_io_fft/fft_input_10frames_hex.txt", mem);
// 按时钟节拍依次送入FFT输入端口
for (i = 0; i < 10240; i = i + 1) begin
@(posedge sys_clk);
in_data <= mem;
end
// 结束仿真
end
always #2.5 sys_clk = ~sys_clk;
demo_fft demo_fft_inst1(
.sys_clk (sys_clk ),
.reset_n (reset_n ),
.in_data (in_data ),
.XK_RE (XK_RE ),
.XK_IM (XK_IM )
);
endmodule
```
- step3 保存并运行仿真
## 结果
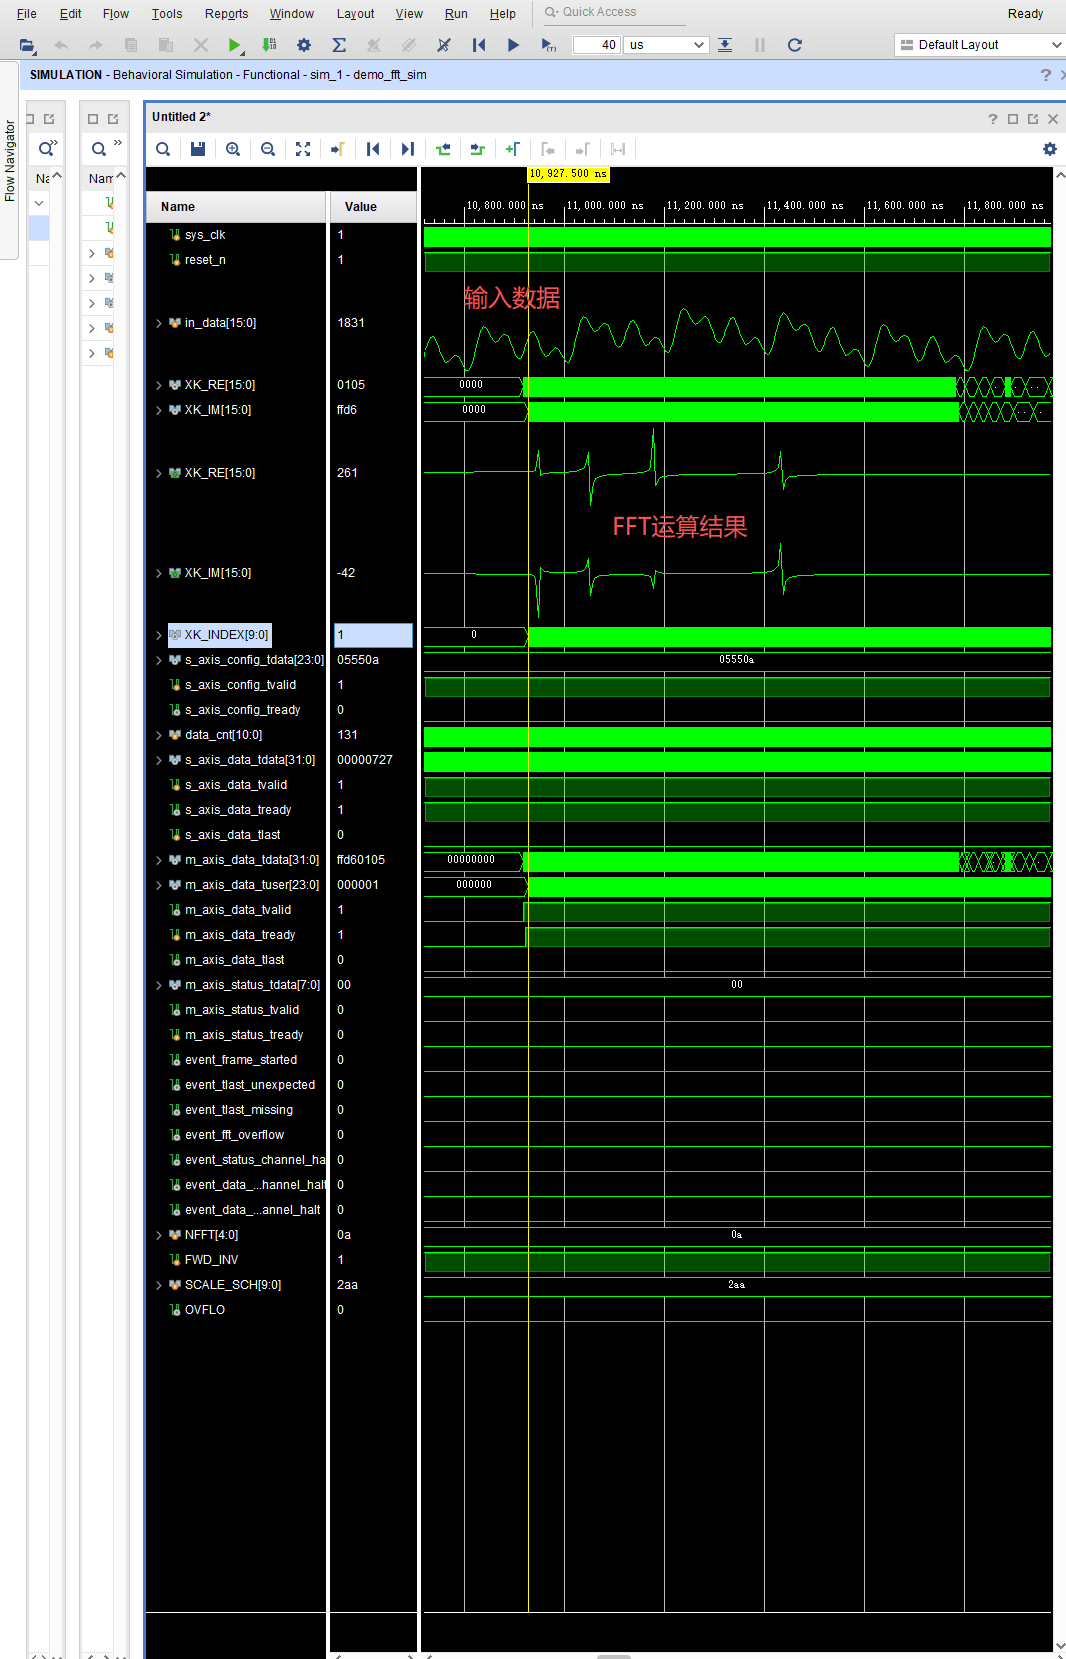
可以看到,从仿真开始,到第一帧的数据输出结束,一共花费了约16us
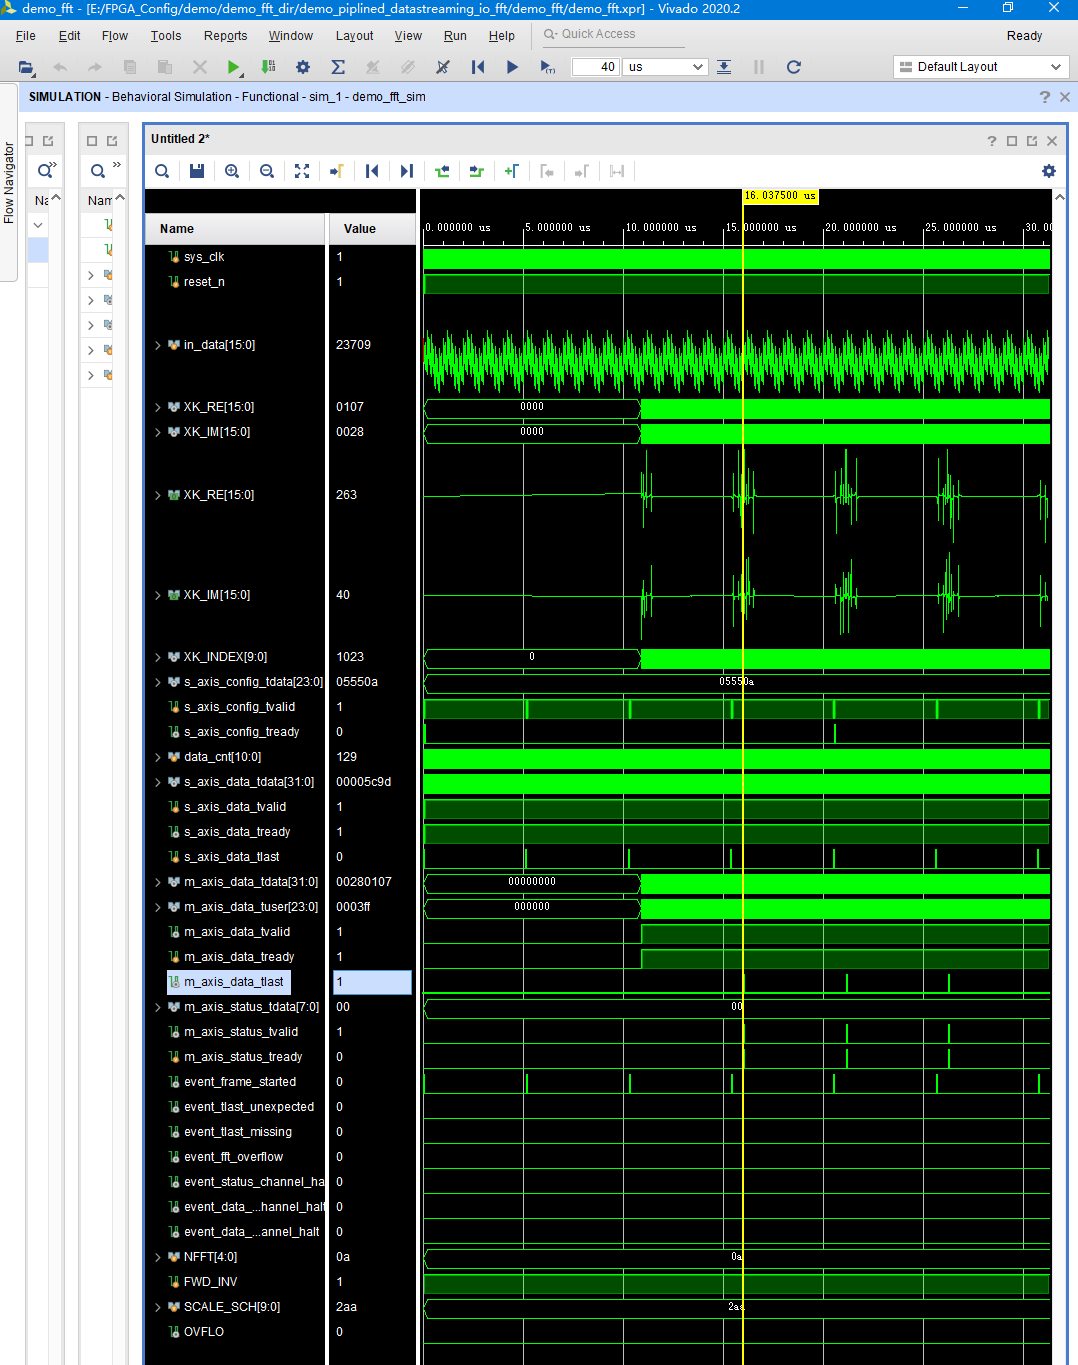
四个峰值点的索引分别为4、25、50和101,对应的频率计算方法为:
$F_K = (b_{xk}+1)*200/1024$
即对应频率为(频率分辨率为$200/1024 \approx 0.195$MHz):0.977、5.078、9.96和19.92MHz,与matlab计算结果一致。
ref:
[^1]:官方技术手册:(https://docs.amd.com/r/en-US/pg109-xfft)
来看一下 666666 谢谢分享 :) :lol:lol:lol:lol 谢谢分享支持楼主 谢谢分享
