马上注册,结交更多好友,享用更多功能,让你轻松玩转社区
您需要 登录 才可以下载或查看,没有账号?立即注册
×
目录计算芯片——V100、A100、H100、B200超级芯片—GH200、GB200节点内连接 - 纵向扩展(超级节点) - DGX GB200 NVL72外部节点互联:Scale-Out(IB和以太网)开发框架:CUDA计算芯片——V100、A100、H100、B200这些型号在讨论AI中最为常见,它指的是AI计算卡 GPU模型。

GPU 卡(6种型号) NVIDIA 每隔几年就会发布一种新的GPU架构,并以一位著名科学家的名字命名。基于特定架构的显卡通常以该架构名称的首字母开头,游戏GPU除外。例如: - V100基于Volta架构(以Alessandro Volta 命名)
- A100源自安培架构(以安德烈-玛丽·安培 (André-Marie Ampère) 的名字命名)
- H100/H200源自Hopper(以Grace Hopper命名)
- B100/B200来自Blackwell(以David Blackwell 命名)

以“200”结尾的型号通常是其“100”前代产品的升级版。例如,H200 是H100的增强版,具有HBM3e内存等改进。L40和L40s。这两款型号的命名略有不同。它们基于Ada Lovelace架构(以纪念第一位女性程序员)。L40s是L40的升级版。两款产品均面向数据中心市场设计,注重成本效益和性能。 H20与出口限制H20是 NVIDIA GPU 的改进版本,旨在应对美国的出口限制。同样,有报道称B200可能有一个受限制的版本,名为 B20。 未来架构 NVIDIA 的下一代 AI 平台 Rubin 计划于 2026 年发布。最初,许多人预计该 GPU 会被标记为 R100/R200,但 NVIDIA 的路线图却暗示了X100系列。该公司计划在2028年推出后续平台 Feynman。
超级芯片—GH200、GB200虽然GPU是NVIDIA计算能力的核心,但该公司还开发了 GPU 之外的补充解决方案。早期合作与CPU开发NVIDIA最初与IBM的 POWER CPU 合作。然而,出于性能方面的考虑,该公司开始开发自己的CPU,例如基于ARM的 Grace CPU,同时Vera CPU也正在开发中。 NVIDIA 利用 NVLink 技术将GPU与CPU配对,打造Superchip平台。示例包括: - GH200(Grace CPU + Hopper GPU)
- GB200(Grace CPU + 两个 Blackwell B200 GPU)
- GB300
GB200 特别强大,其性能约为 H100 的七倍。

超级计算机平台——DGX、EGX、IGX 在更高的计算层面,NVIDIA基于这些芯片架构开发了超级计算机平台,包括DGX、EGX、IGX、HGX和MGX。

DGX系列众所周知,Jensen Huang将第一代DGX-1赠送给了OpenAI。

如今,现代 DGX 系统通常具有标志性的金色设计和高昂的价格。 对于桌面应用程序,NVIDIA 提供 DGX Spark 和 DGX Station,可作为工作站级机器运行。

节点内连接 - 纵向扩展(超级节点)在通信层面,NVIDIA 开发了NVLink,这是一项旨在互联GPU的技术,可有效取代PCIe。它也通过 NVLink连接CPU和GPU。

对于多节点设置,直接NVLink连接变得不切实际,需要使用NVLink 交换机芯片(也称为 NVSwitch)。随着时间的推移,这些芯片逐渐演变成独立的设备。

NVLink 可以将众多GPU连接到统一的逻辑节点,从而形成一个超大规模计算平台。一个经常被提及的配置是DGX GB200 NVL72,它利用 NVLink5 来实现: - 18 个计算托盘(每个包含两个 GB200 超级芯片)
- 9 个 NVLink 网络交换机托盘
每个计算托盘包含:2 个 GB200 超级芯片(整个系统共有 36 个 Grace CPU 和 72 个 B200 GPU)。

此外,可以组合八个DGX GB200 NVL72 单元来创建一个具有576个GPU 的SuperPod 节点。这种结构化的产品生态系统定义了NVIDIA在AI和高性能计算领域的定位。

外部节点互联:Scale-Out(IB和以太网)在单个节点内,持续添加GPU被称为Scale-Up(垂直扩展)。然而,当节点达到一定规模后,进一步扩展将变得困难。此时,需要增加节点数量并将它们互连,这被称为Scale-Out(水平扩展)。

NVIDIA 主要通过InfiniBand (IB) 技术提供Scale-Out解决方案。InfiniBand 最初由 Mellanox 开发,在2019年NVIDIA收购 Mellanox 后成为NVIDIA的专有技术。InfiniBand是一个技术术语,而非产品名称;NVIDIA基于InfiniBand的产品平台是NVIDIA Quantum。例如,NVIDIA 于2024 年3月发布Quantum-X800网络交换机平台,该平台实现800 Gbps的端到端吞吐量。该平台包含Quantum Q3400交换机和ConnectX-8 SuperNIC网卡等硬件。这些组件属于一个更广泛的系列——Quantum-X800继承了其前身Quantum-2,而ConnectX-8之前则有ConnectX-6和ConnectX-7。

ConnectX高速网卡也源自Mellanox。InfiniBand 是两大主要的 Scale-Out 解决方案之一,另一个是以太网。NVIDIA 也在这个领域开发了产品,尤其是 Spectrum-X800 平台。Spectrum-X800 系列包括 Spectrum SN5600交换机和BlueField-3 SuperNIC 网卡,吞吐量同样高达 800Gbps。

BlueField 作为数据处理单元 (DPU) 备受关注。NVIDIA 将 Mellanox 的 ConnectX 网卡技术与自身创新相结合,于 2020 年正式推出了 BlueField-2 DPU 和 BlueField-2X DPU。此后,该技术逐渐演进为 BlueField-3。此外,NVIDIA近期还推出了CPO(Co-Packaged Optics)集成网络交换机,包Spectrum-X Photonics和Quantum-X Photonics。

开发框架:CUDA软件组件 CUDA 。NVIDIA 虽然在硬件和网络方面表现出色,但其 CUDA 平台被广泛认为是其核心竞争优势。CUDA(统一计算设备架构)是 NVIDIA 于 2006 年推出的并行计算平台和编程模型。它使开发人员能够直接为 GPU 编写代码,从而显著提高计算性能。 如今,CUDA 作为智能计算的操作系统,集成了编程模型、编译器、API、库和工具,帮助用户最大限度地发挥 NVIDIA 硬件的功能。 CUDA 不仅仅是一个工具,它还构建了一个强大的 AI 开发生态系统,充当着 NVIDIA 整个业务框架的中枢神经系统。许多 AI 开发项目严重依赖 NVIDIA 的硬件和 CUDA,虽然切换硬件相对简单,但迁移整个生态系统却面临着更大的挑战。

| 


 闽公网安备35062302000276号 | 闽ICP备2024076463号-1 | 论坛技术支持QQ群171867948 | 论坛问题,充值问题请联系QQ1308068381


 再发某公司的PADS格式 PCB封装库全套共享
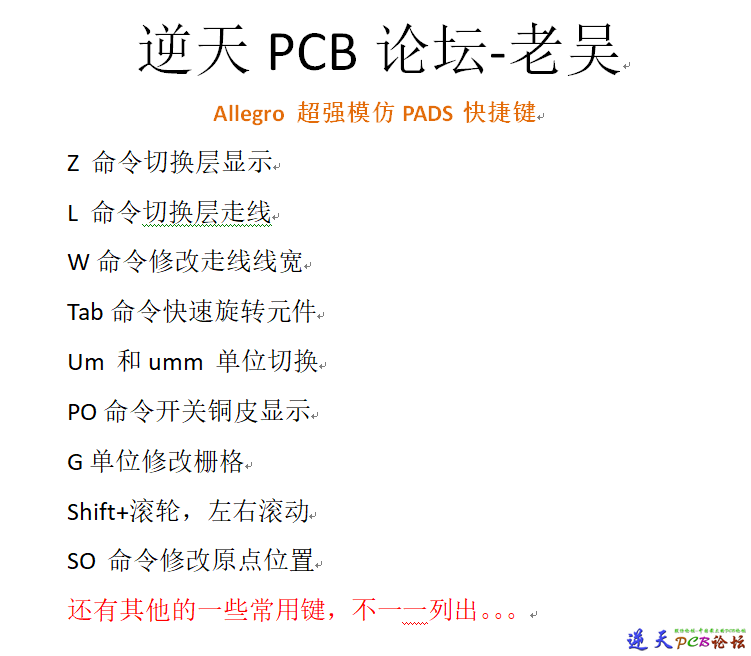 Allegro超强最全模仿PADS快捷键实现Z切换层
 AD格式RK3568 NVR PCB和原理图
 深圳思傲拓泳池机器人Sonar30产品完全解剖
 Mstar MSD3553NUA TSUMV56RU_QFP128 高清液
 先楫半导体HPM6800EVK_RevC挂一个DDR3 4层P
 74lvc245 + MC34063 +IR2104S +IR7843做的
 allegro羊皮卷
 8×16点阵VK16D33AA SSOP28抗噪/抗干扰LED
 intel英特尔I7电脑主板实战录像
 像这种自行车的雷达尾灯,用的雷达是超声波
 CS5926C这款降压充电管理IC,让超级电容充
 PCB Toolkit V8.43汉化版PCB参数计算神器
 微型太阳能板给微型锂电池充电的问题(资料
 XC7VX690T-2FFG1927I 芯片引脚扩展板测试板全部IO 引出到插件引脚
 欧冶半导体龙泉560 LQ560V200 AI SoC芯片车规自动驾驶SoC芯片邮票孔核心板PCB
 CN3765锂电池充电器
 单板计算机BeagleBone_Black 全套图纸—DSN、BRD、BOM
 S3C2440 Altium Designer - 6 Layer Dev. Board - PCB+SCH
 MT7986B(MT7986BC) +MT7975+MT7531 做的高端路由器PCB文件
 倍IMX291+Hi3516A


 发表于 2025-7-30 00:28