马上注册,结交更多好友,享用更多功能,让你轻松玩转社区
您需要 登录 才可以下载或查看,没有账号?立即注册
×
之前有留言提出问题:

可以拆分成以下几个问题: 这里根据个人理解进行回答,如果有错,私密马赛~~
有其他DRAM相关问题,也欢迎留言讨论~
使能auto-prechange后,是否每一笔读写命令都会自带auto-precharge 首先第一个问题先给答案:使能auto-prechange后,不是每一笔读写命令都会自带auto-precharge。在解释前,需要提前了解一下DRAM页面策略(page policy)分为open-page policy和close-page policy。 open-page policy 开页策略核心思想是,在一次访问后保持页面的打开状态,以便后续操作能够快速访问同一页面内的其他地址。开页策略在处理具有顺序访问模式的数据时特别高效,因为不需要频繁PRE和ACT打开页面,从而减少了延迟并提高了系统效率。如果数据访问模式符合“重复读取或写入同一页面内的连续地址”,理论上可以达到100%的效率,但实际应用中由于周期性刷新的影响,效率会有轻微损失(约2-3%)。此外,因为一直保持page open,访问同一页面内的不同column时不需要发送ACT命令,开页策略还可以最大程度地减少高优先级事务的延迟(主要减去tRCD带来的延迟)。 close-page policy 在闭页策略下,每次访问一个内存页后,该页都会被立即关闭(即通过自动预充电命令)。这种策略适用于某些特定的数据访问模式,例如当数据访问模式不是集中于同一内存页,而是分散在多个不同页时。在这种情况下,系统的效率取决于连续页未命中的处理能力,而主要的效率损失则来tRCD, tRASmin, tRP的开销和周期性刷新操作。可以参考之前文章中随机访问场景,效率一般只有10%~20%。
如果每一笔读写命令都有auto-precharge命令,那么意味着每次访问都是ACT->WR/RD w/ auto-PRE, 这样一来连续同页访问就会被打断激活状态,成为随机访问场景,造成带宽利用率下降。参考之前文章,在随机场景下使用RDA或者WOMA命令,自带的auto-prechange操作也是需要满足tRP时序的。WR/RD w/ auto-precharge命令在完全随机的场景下,也没有收益。(这里仅考虑理想的连读地址访问和完全随机的地址访问场景)
auto-prechange命令的性能收益在哪 如果使能auto-precharge功能,在完成对当前page的最后一笔访问之后关闭page,那么该bank的下次其他page访问过来的时候,可以节省下发送PRE的时间(节省tRP的时间),直接发送ACT命令。这可以提升访问效率。 实际业务场景中,业务流不可能是非常理想的连续地址访问或者随机的地址访问。所以当前DDR控制器通常使用dynamic page policy。在DDR控制器中增加look-ahead逻辑,根据激励输入来决定是否发送auto-precharge命令。(各家叫法不一样,不过大概思想都是相似的) 比较简单的实现逻辑:在收到AXI激励后,DDRC将AXI地址拆解为bank-row-col地址。DDRC中收到命令后会将命令信息先存到Timer Bank Pool(TBP)。那么DDRC在调度命令时,会look-ahead TBP中的信息。当TBP中有相同bank-row的命令时,调度命令时就不发送auto-precharge命令。有同bank不同row的命令时,调度auto-prechareg命令。此外,还可以考虑引入刷新命令,close page timer,qos等等因素,通过仲裁逻辑来决定是否发送auto-precharge命令。
ACT-PRE之间可以插入多少笔读写命令 如果我们使用open-page policy,并且所有访问都是集中在同一个page policy。这里主要受限于刷新时序tREFI。以GDDR6为例子,ACT->PRE需要满足tRAS,而tRASmin是激活bank之后到发送PRE命令间隔的最小值,最大值为9 * tREFI。GDDR6中引入了postpond refresh或者pull-in refresh,从而让refresh命令调度更加灵活。但是协议规定最多可以postpond或者pull-in 8个refresh命令,所以tRASmax = 9 * tREFI。
考虑tRCD和tRP的影响,在访问同一个page的场景中,单独读/写命令分别需要满足tCCD: 单独读/写命令数量 = (tRASmax-tRP-tRCD) / tCCD读写混合场景需要考虑读写切换引入的开销 tWTR/tRTW,假设每16次读命令切换一次写方向,16笔写命令切换一次读命令。计算tRASmax时间内,能够完成多少次读写切换次数,从而计算读写命令数量: 读写混合场景命令的数量 = (tRASmax-tRP-tRCD) / ((16 * tCCD + tWTR) + (16 * tCCD +
| 


 闽公网安备35062302000276号 | 闽ICP备2024076463号-1 | 论坛技术支持QQ群171867948 | 论坛问题,充值问题请联系QQ1308068381


 再发某公司的PADS格式 PCB封装库全套共享
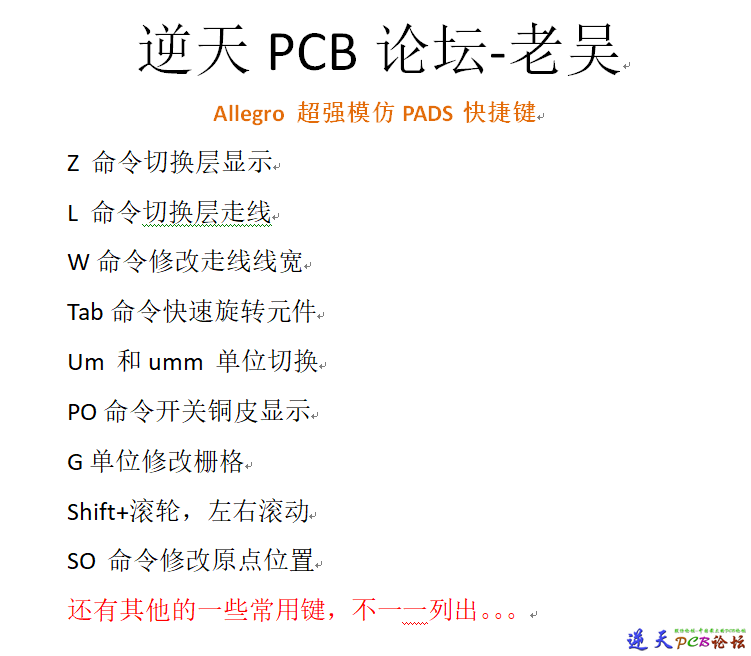 Allegro超强最全模仿PADS快捷键实现Z切换层
 AD格式RK3568 NVR PCB和原理图
 深圳思傲拓泳池机器人Sonar30产品完全解剖
 Mstar MSD3553NUA TSUMV56RU_QFP128 高清液
 先楫半导体HPM6800EVK_RevC挂一个DDR3 4层P
 74lvc245 + MC34063 +IR2104S +IR7843做的
 allegro羊皮卷
 GERBER文件中各文件与PCB各层的对应关系
 PCB Toolkit V8.43汉化版PCB参数计算神器
 电子吧唧、蓝牙耳机充电保护主芯方案!!
 车载视频总线FPD-Link III和GMSL通过SerDes
 低成本远距离场控方案:芯岭 XL2400T 打造
 脉冲调整电路原理图
 CN3765锂电池充电器
 欧冶半导体龙泉560 LQ560V200 AI SoC芯片车规自动驾驶SoC芯片邮票孔核心板PCB
 单板计算机BeagleBone_Black 全套图纸—DSN、BRD、BOM
 S3C2440 Altium Designer - 6 Layer Dev. Board - PCB+SCH
 MT7986B(MT7986BC) +MT7975+MT7531 做的高端路由器PCB文件
 倍IMX291+Hi3516A
 带锂电池的功放板


 发表于 2025-6-4 23:53